Mac mini実測 30B級のローカルLLMが毎秒61トークン 前夜の見込みは3つ外れた
Mac mini(Apple M6、メモリ32GB)が届いた。前夜の記事で立てた見込みを、実測で確かめた。
結果から書く。見込みは3つ外れた。 しかも、外れ方が良いほうに1つ、悪いほうに2つだった。
測った条件
SSHでMac miniに入り、Ollamaを常駐させて、7つのモデルを同じ条件で測った。
- 入力の長さの上限(num_ctx)は16384に固定
- 同時に載せるモデルは1つ、並列リクエストも1つ
- 生成は200トークンで打ち切り、温度は0
- 各モデルで「短い質問」と「約1万トークンの長文要約」の2本を実行
測ったのは3つ。モデルを読み込む時間、答えを書く速さ(トークン/秒)、長い入力を読む速さだ。
結果
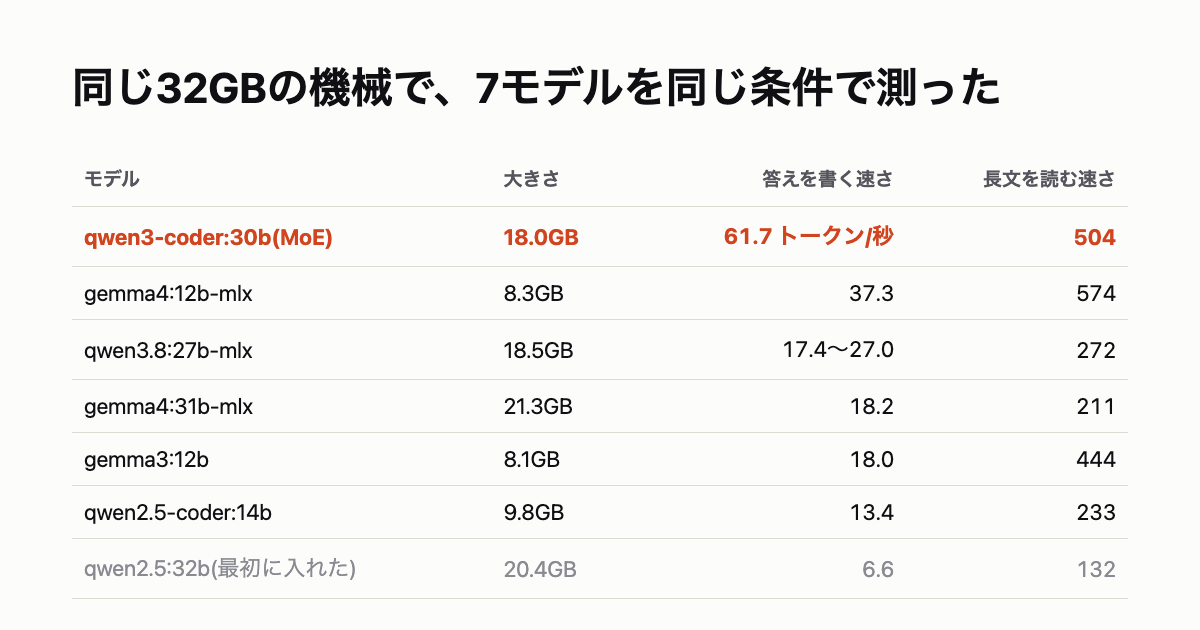
| モデル | メモリ | 読み込み | 生成速度 | 長文の読み込み |
|---|---|---|---|---|
| qwen3-coder:30b | 18.0GB | 5.4秒 | 61.7 tok/s | 504 tok/s |
| gemma4:12b-mlx | 8.3GB | 0.6秒 | 37.3 tok/s | 574 tok/s |
| qwen3.8:27b-mlx | 18.5GB | 7.0秒 | 17.4〜27.0 tok/s | 272 tok/s |
| gemma4:31b-mlx | 21.3GB | 7.7秒 | 18.2 tok/s | 211 tok/s |
| gemma3:12b | 8.1GB | 1.4秒 | 18.0 tok/s | 444 tok/s |
| qwen2.5-coder:14b | 9.8GB | 0.8秒 | 13.4 tok/s | 233 tok/s |
| qwen2.5:32b | 20.4GB | 6.7秒 | 6.6 tok/s | 132 tok/s |
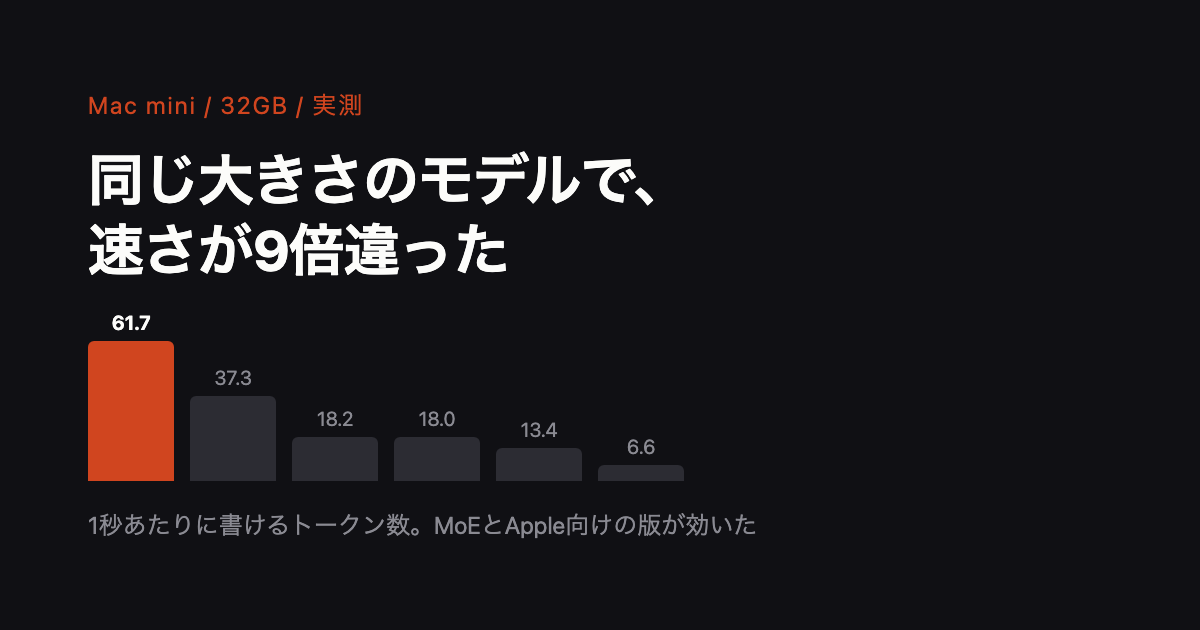
表の一番上と一番下は、どちらも18〜20GBの同じサイズ帯だ。それで9倍の差がついた。
外れ1 32B級は遅い、は誤りだった
前夜は「32Bは1つ約20GBあり、32GBのマシンには重い」と書いた。最初に測ったqwen2.5:32bは6.6 tok/sで、日本語なら1秒に4〜5文字。予想どおり遅かった。
このとき私は、原因をメモリ帯域だと説明した。1トークン書くたびにモデル全体(20GB)を読み直す必要があるので、メモリの読み出し速度が上限を決める、という理屈だ。Mac miniの帯域はおよそ150GB/秒なので、20GBを読むなら毎秒7回。実測の6.6とよく合う。
理屈は合っていた。だが結論が間違っていた。 この理屈には「モデル全体を読み直すなら」という前提が付いている。前提を外せる作り方が2つあった。
1つ目はMoE(混合エキスパート)。 qwen3-coder:30bはこの作りで、18GBを載せていても、1トークンごとに実際に読むのはその一部だけだ。30人の料理人を雇っていても、1つの注文に手を動かすのは3人、という仕組みに近い。控室(メモリ)は30人分いるが、動く人数が少ないので速い。結果が61.7 tok/sだった。
2つ目はmlx版。 MLXはApple製チップ向けに書かれた実行方式で、同じモデルでも計算のやり方が違う。gemma4:31b-mlxは18.2 tok/sで、旧世代のqwen2.5:32bの2.8倍出た。サイズはほぼ同じだ。
教訓は「帯域の見積もりで足切りしない」。 モデルの作りと実行方式で、同じサイズが数倍変わる。
外れ2 載せ替えは2、3秒では終わらない
前夜は「載せ替えは2、3秒程度を見込んでいる」と書いた。実測はこうだった。
| 載せ替え | 最初の返事まで |
|---|---|
| 12B → 30B(MoE) | 7.2秒 |
| 12B → 31B | 13.7秒 |
| 31B → 12B | 4.1秒 |
小さいほうへ戻るのは速く、大きいほうへ行くのは遅い。 19GBをSSDから読むぶん、行きは時間がかかる。見込みの5倍だ。
実用上はこれで困らない。困るのは、会話の途中で用途が切り替わったときに13秒黙ることだ。採用する2モデルの合計が26GBで同時常駐できないので、ここは受け入れる。
外れ3 モデルの世代が2つ古かった
これは技術ではなく、私の調べ方の問題だ。
最初に入れたのはqwen2.5だった。AIに相談しながら選んだのだが、AIの知識には期限がある。私も「有名だから」で受け入れてしまった。指摘を受けて調べ直すと、qwen3.8とqwen3-coderが出ていて、gemmaも4になっていた。
そして、いちばん速かったqwen3-coder:30bは、この調べ直しで初めて出てきたモデルだ。最初の選択のままなら、9倍遅い環境を「こんなものか」と受け入れていた。
モデル名は https://ollama.com/library/<名前> を開けば一覧で確認できる。新しい環境を組むときは、AIの回答ではなく、この一覧を先に見るべきだった。
採用した構成
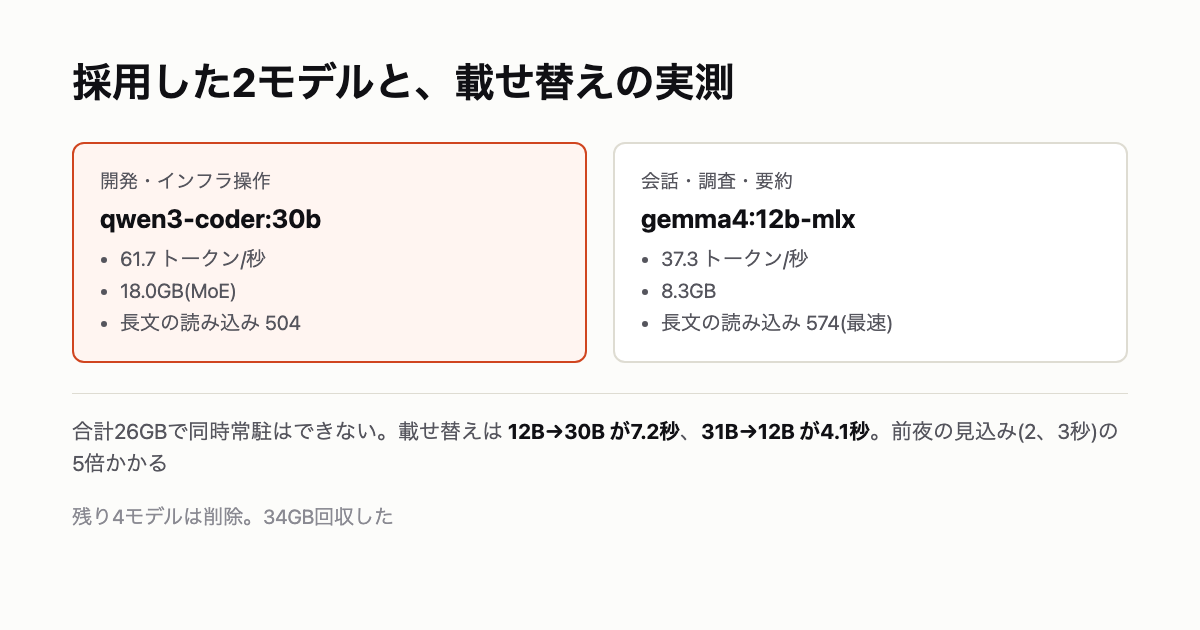
- 開発・インフラ操作: qwen3-coder:30b(61.7 tok/s、18GB)
- 会話・調査・要約: gemma4:12b-mlx(37.3 tok/s、8.3GB、長文の読み込みが最速)
- 残り4モデルは削除した。すべて上の2つに劣る。34GB回収した。
Ollamaはbrew servicesではなく、自前のLaunchAgentで常駐させている。Homebrewが作る設定ファイルは更新のたびに作り直され、環境変数の指定が消えるためだ。
# 自前のLaunchAgentに入れている設定
OLLAMA_MAX_LOADED_MODELS=1   # 同時に載せるのは1モデル
OLLAMA_NUM_PARALLEL=1        # 並列リクエストでメモリを食わせない
OLLAMA_FLASH_ATTENTION=1     # 注意機構のメモリ節約
OLLAMA_KV_CACHE_TYPE=q8_0    # 途中結果を8bitで持つ
OLLAMA_HOST=127.0.0.1:11434  # 外からは受け付けない
クラウドと比べてどうか
61.7 tok/sは、クラウドの主力モデルの生成速度と同じ水準だ。答えが流れてくる速さだけを見れば、机の上の箱がデータセンターに並んだことになる。従量課金はかからず、入力も外に出ない。
ただし、並んだのは「書く速さ」だけだ。
長い入力を読む速さは、まだはっきり負けている。1万トークンで20秒前後かかる。クラウドは1〜2秒だ。クラウドで長文が遅いと感じるのは、読むのが遅いからではなく、長い答えを書くからで、遅さの理由が違う。ローカルは読むのも書くのも遅い。長い書類を投げる仕事では、この差がそのまま出る。
賢さも、まだ測っていない。速さは数字で出せるが、コードの正しさはそうはいかない。
次にやること
- qwen3-coder:30bに、このリポジトリの実際の修正を投げて使えるか見る
- gemma4:12b-mlxと31b-mlxで、日本語の要約の質を比べる
- OpenClawを入れて、Discordからの指示で返事が返るまでを通す
速度は十分だと分かった。ここから先は「速いか」ではなく「仕事になるか」の話になる。