Mac miniを常時稼働のAIサーバーにする前夜 計画書の穴4つとモデル切り替えの設計
明日、Mac mini(メモリ32GB)が届く。24時間動かしておくローカルAIサーバーにする。
構築手順は先にAIに書かせた。着手前に1行ずつ確かめたところ、そのまま流すと止まる箇所が4つあった。 この記事は、その4つと、32GBの制約をどう受けるかの設計を、手を動かす前の時点で残しておくものだ。 実測は明日以降に追記する。
構成
Mac miniを常時稼働の司令塔にする。エージェント(OpenClaw)とローカルLLMの実行エンジン(Ollama)をここに置き、 各サービスの操作もここから行う。画像・動画の生成のようにGPUが要る仕事だけ、LAN内のWindows(RTX 5070 Ti)で動くComfyUIへ投げる。
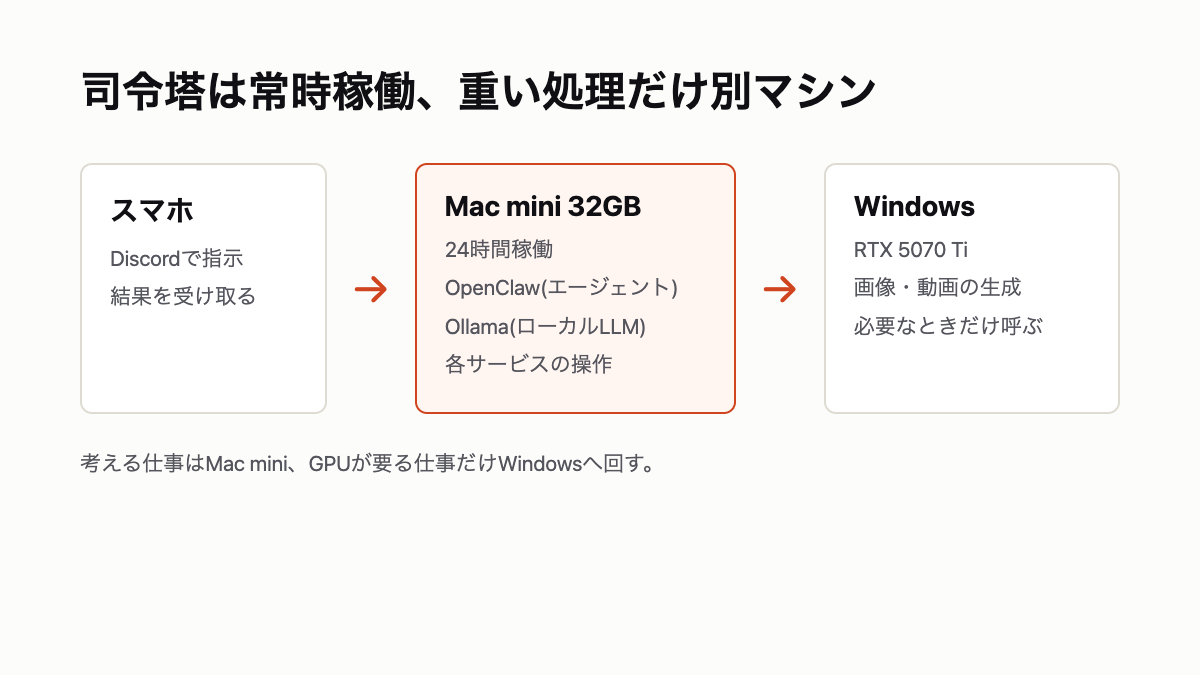
指示はDiscordから出す。LLMはローカルで動かすので、APIの従量課金は発生しない。
計画書の穴
AIが出した計画書は、見出し・表・コピペ用コマンドまで揃っていた。確かめた結果が次の表だ。
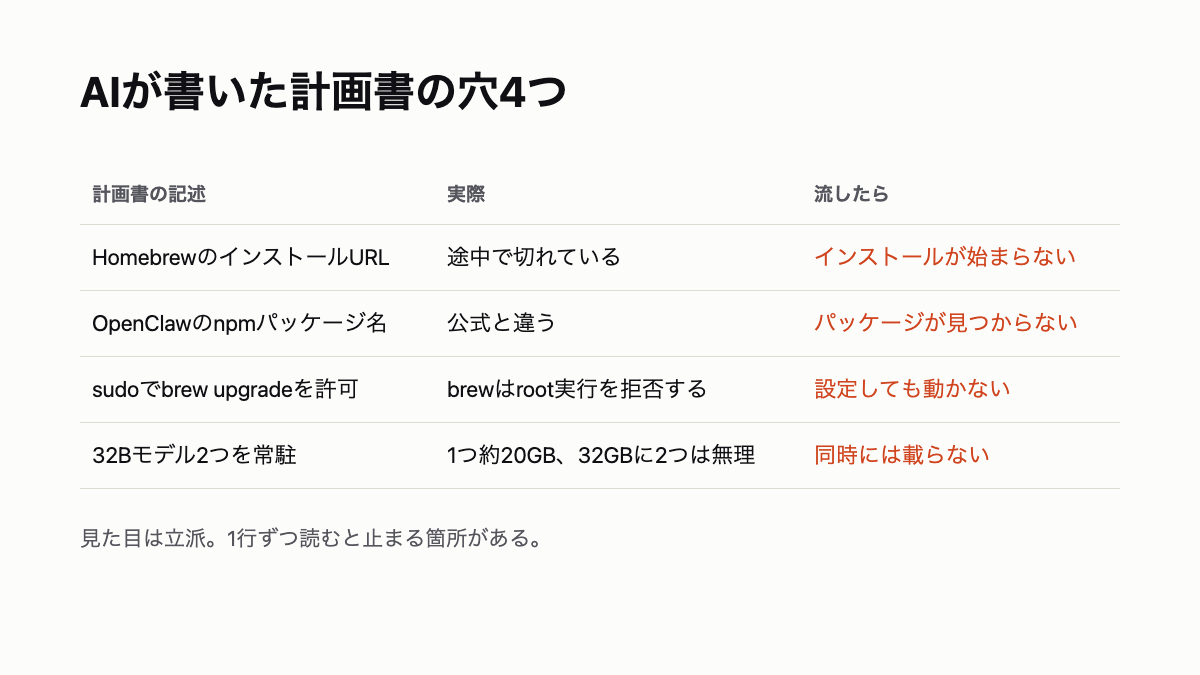
1つずつ直し方を書いておく。
HomebrewのインストールURL。 ドメインだけで切れていた。正しくはHomebrew公式に載っている次の形になる。
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"
OpenClawのパッケージ名。 計画書はスコープ付きの名前を書いていたが、公式の名前と一致しない。 パッケージ名と設定ファイルの形式は、当日に公式READMEで確かめてから入れる。設定ファイルも手で書かず、 対話式の初期設定(onboard)に任せてから差分だけ直す。
sudoでbrew upgradeを許可する設定。 Homebrewはroot権限での実行を拒否する。そもそもsudoが要らない。 パスワードなしのsudoを許すのは、再起動のように本当にroot権限が要るコマンドに絞る。
32Bモデル2つの常駐。 次の章で扱う。
もう1つ、brew install docker で入るのはCLIだけで、Docker本体は入らない。Docker Desktopかcolimaを別に入れる。
32Bが2つ載らない問題は、載せ替えで受ける
Qwen2.5の32Bは、4bit量子化で1つ約20GBある。macOSはGPUに回せるメモリを物理メモリの一部に制限しているので、 32GBのマシンに2つ同時に置くことはできない。1つでも、入力を長く取ると余裕がなくなる。
ここで小さいモデルに逃げるのではなく、同時に載せない前提で運用を組むことにした。
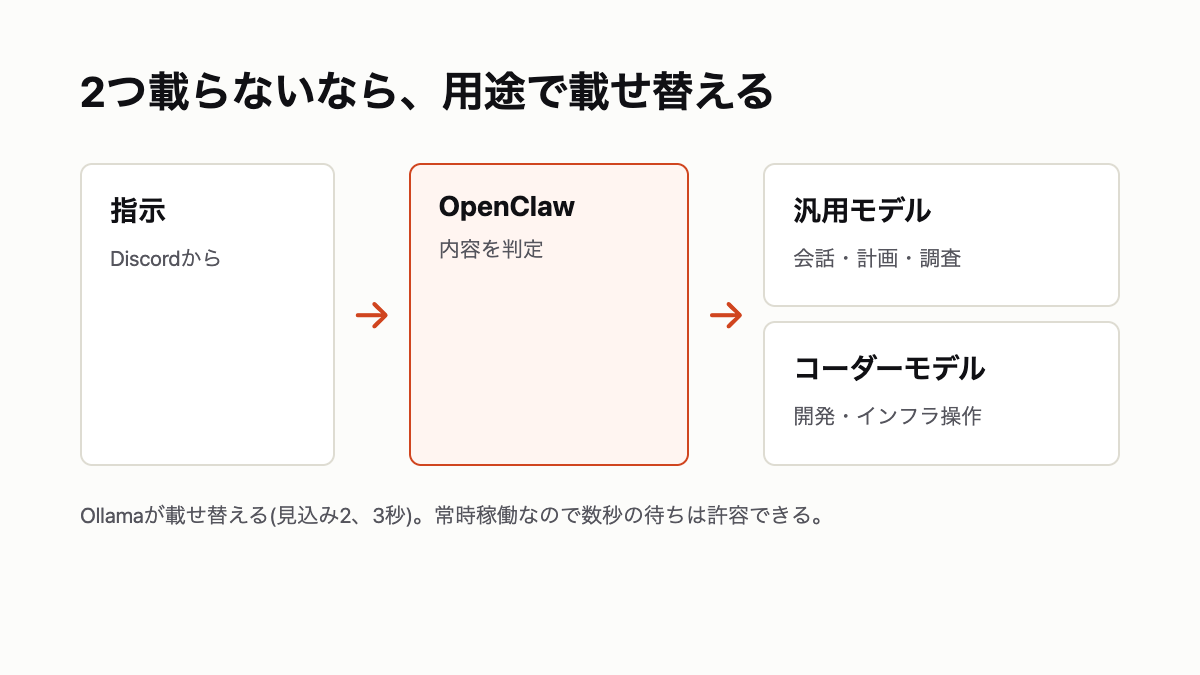
- 会話・計画・調査は汎用モデル、開発・インフラ操作はコーダーモデルに振り分ける
- どちらに振るかはOpenClawが指示の内容から判定する
- Ollama側はメモリに載せるモデルを1つに制限し、呼ばれたモデルへ載せ替えさせる
# Ollamaの設定(見込み)
OLLAMA_MAX_LOADED_MODELS=1   # 同時に載せるのは1モデルまで
OLLAMA_NUM_PARALLEL=1        # 並列リクエストでメモリを食わせない
載せ替えは2、3秒程度を見込んでいる。常時稼働のサーバーなので急ぎの仕事は少なく、数秒の待ちは許容できる。 人が「今どちらのモデルか」を意識しなくて済むことのほうが価値が大きい。
ただし、ここは見込みでしかない。 約20GBをSSDから読み直すので、実際の秒数は測るまで分からない。 入力の長さ(num_ctx)も8k〜16kあたりから始めて、メモリの余りを見ながら決める。
鍵の渡し方
エージェントには各サービスのTokenを渡すことになる。ローカルLLMが指示を取り違えたときに、被害が大きくならない順に渡す。
- Tokenは1本ずつ、権限を絞れるものから追加する
- 範囲を絞れないTokenは、必要になるまで渡さない
- Discordは自分のアカウントからの指示だけを受け付ける
- 生成用のWindowsは、LAN内のMac miniからだけ接続できるようにする
明日確かめること
- Discordから送った指示に返事が返るまで
- モデルの載せ替えにかかる実際の秒数
- 32Bモデル1つを載せたときのメモリの余りと、入力の長さの上限
- 返答の速さ(1秒あたりのトークン数)
結果はこの記事に追記する。